92 % à l'examen, 44,8 % au lit du patient : ce qu'un score d'IA ne dit pas
3 septembre 2026 · La rédaction Médicilline
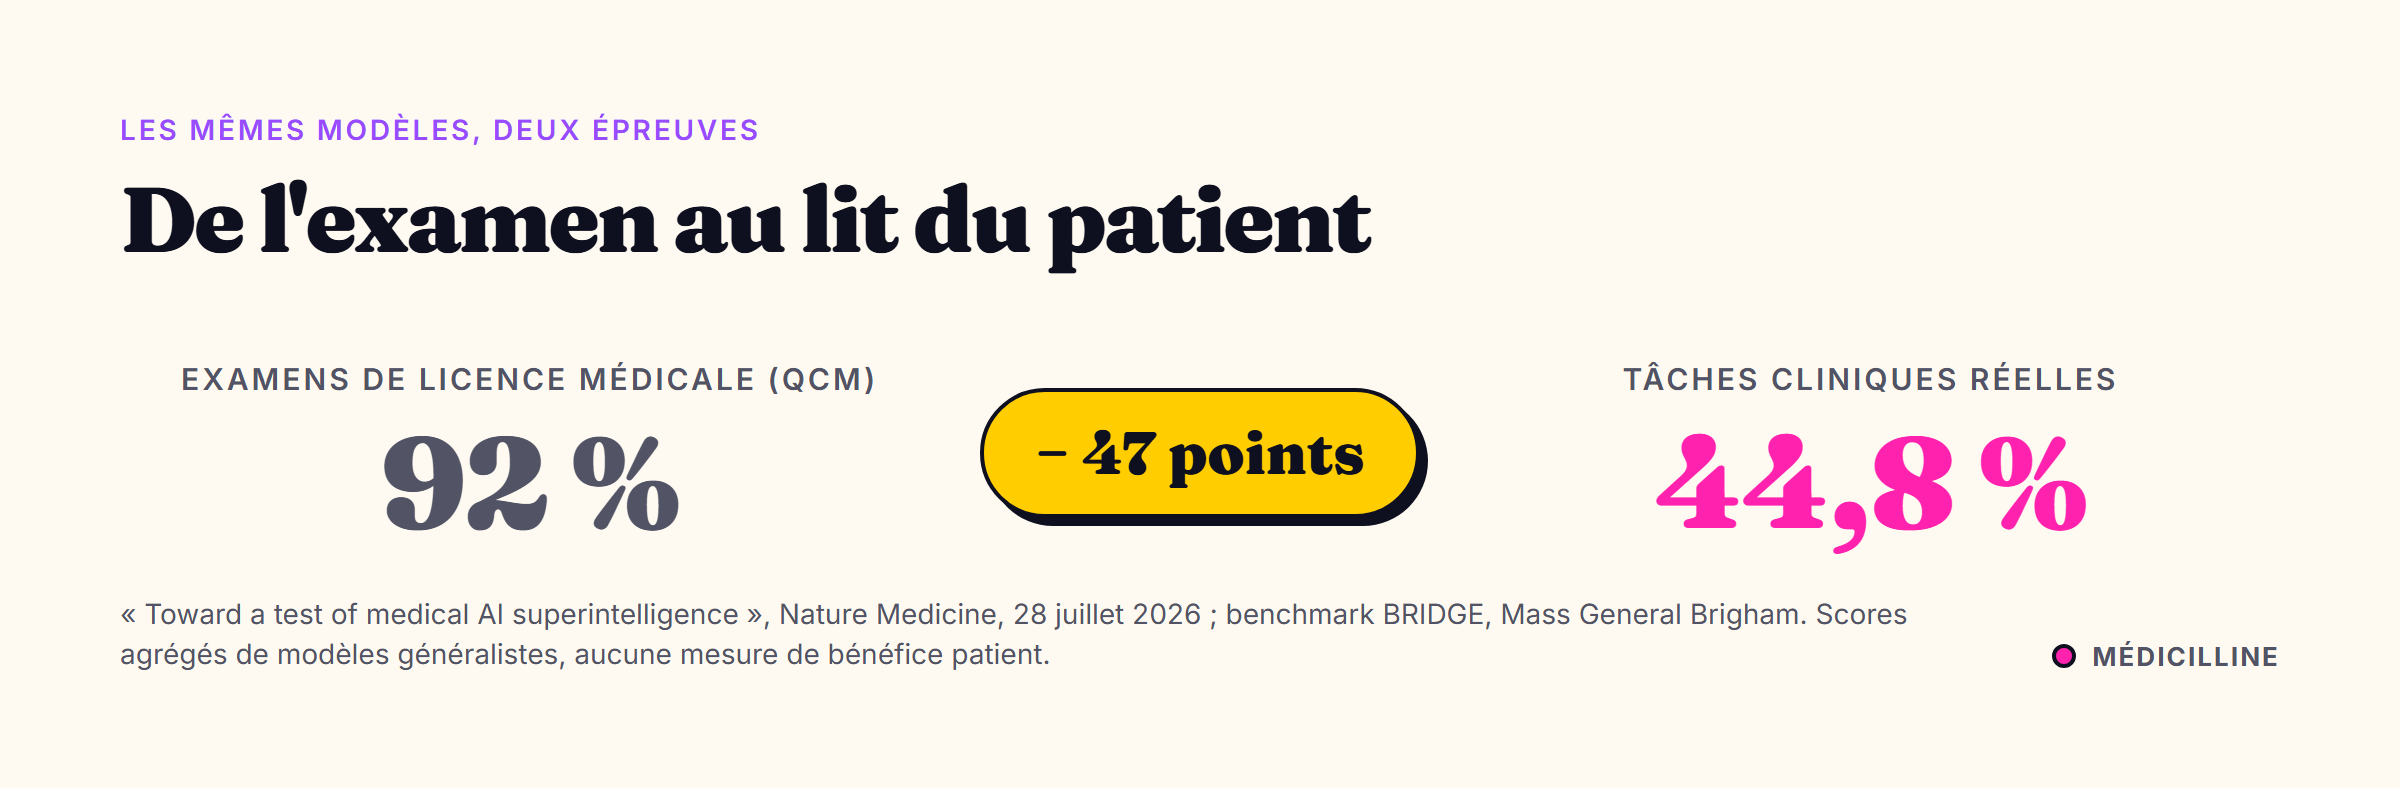
Les grands modèles réussissent les examens de médecine. Sur des tâches cliniques réelles, ils tombent à 44,8 %. L'écart n'est pas une panne : les deux épreuves ne mesurent pas la même chose.
Tout étudiant en médecine connaît la différence entre réussir un QCM et tenir une consultation. Les grands modèles de langage viennent d'en faire la démonstration à grande échelle : environ 92 % de réussite aux examens de licence médicale, 44,8 % sur des tâches cliniques réelles. Un cadre d'évaluation publié dans Nature Medicine le 28 juillet 2026 propose de prendre cet écart au sérieux.
Pourquoi un QCM est une épreuve facile pour une machine
Un énoncé d'examen est un cas déjà trié. Les éléments pertinents ont été sélectionnés par l'auteur de la question, les distracteurs sont connus, et la bonne réponse figure toujours dans la liste. Le travail consiste à reconnaître, pas à décider. C'est précisément ce qu'un modèle entraîné sur des millions de textes fait le mieux.
En consultation, aucune de ces conditions n'est réunie. Le patient arrive avec un motif, des antécédents partiels et des symptômes dont la moitié se révélera sans rapport. Le geste clinique consiste d'abord à décider quelle information manque et laquelle ignorer — une opération que les examens standardisés ne testent à aucun moment. Le benchmark BRIDGE, développé par Mass General Brigham sur des tâches issues de dossiers réels, mesure cette opération. Les scores s'y effondrent.
Ce que cela enseigne, au-delà de l'IA
L'écart de 47 points est aussi une leçon de pédagogie médicale. Il rend visible ce que les enseignants savent depuis longtemps : la restitution et le raisonnement sont deux compétences distinctes, et la première prédit mal la seconde. Un outil qui « réussit l'examen » n'a démontré que la première. C'est vrai d'un modèle ; c'est vrai aussi d'un étudiant, et c'est pour cela que l'externat existe.
Pour les étudiants et les internes qui utilisent déjà ces outils pour réviser, la conséquence est nette : un modèle est un excellent partenaire de restitution — fiches, définitions, reformulations — et un partenaire fragile de raisonnement clinique. Lui demander « quel est le diagnostic » revient à lui poser une question d'examen sur un cas qui n'en est pas un.
Trois questions avant de croire un score
Le score global qu'un éditeur affiche ne vous renseigne pas. La question utile n'est pas « quel score obtient cet outil » mais « sur quelles tâches a-t-il été évalué, et ressemblent-elles à ma pratique ». Un outil validé sur la rédaction de comptes rendus ne dit rien de sa fiabilité en diagnostic différentiel.
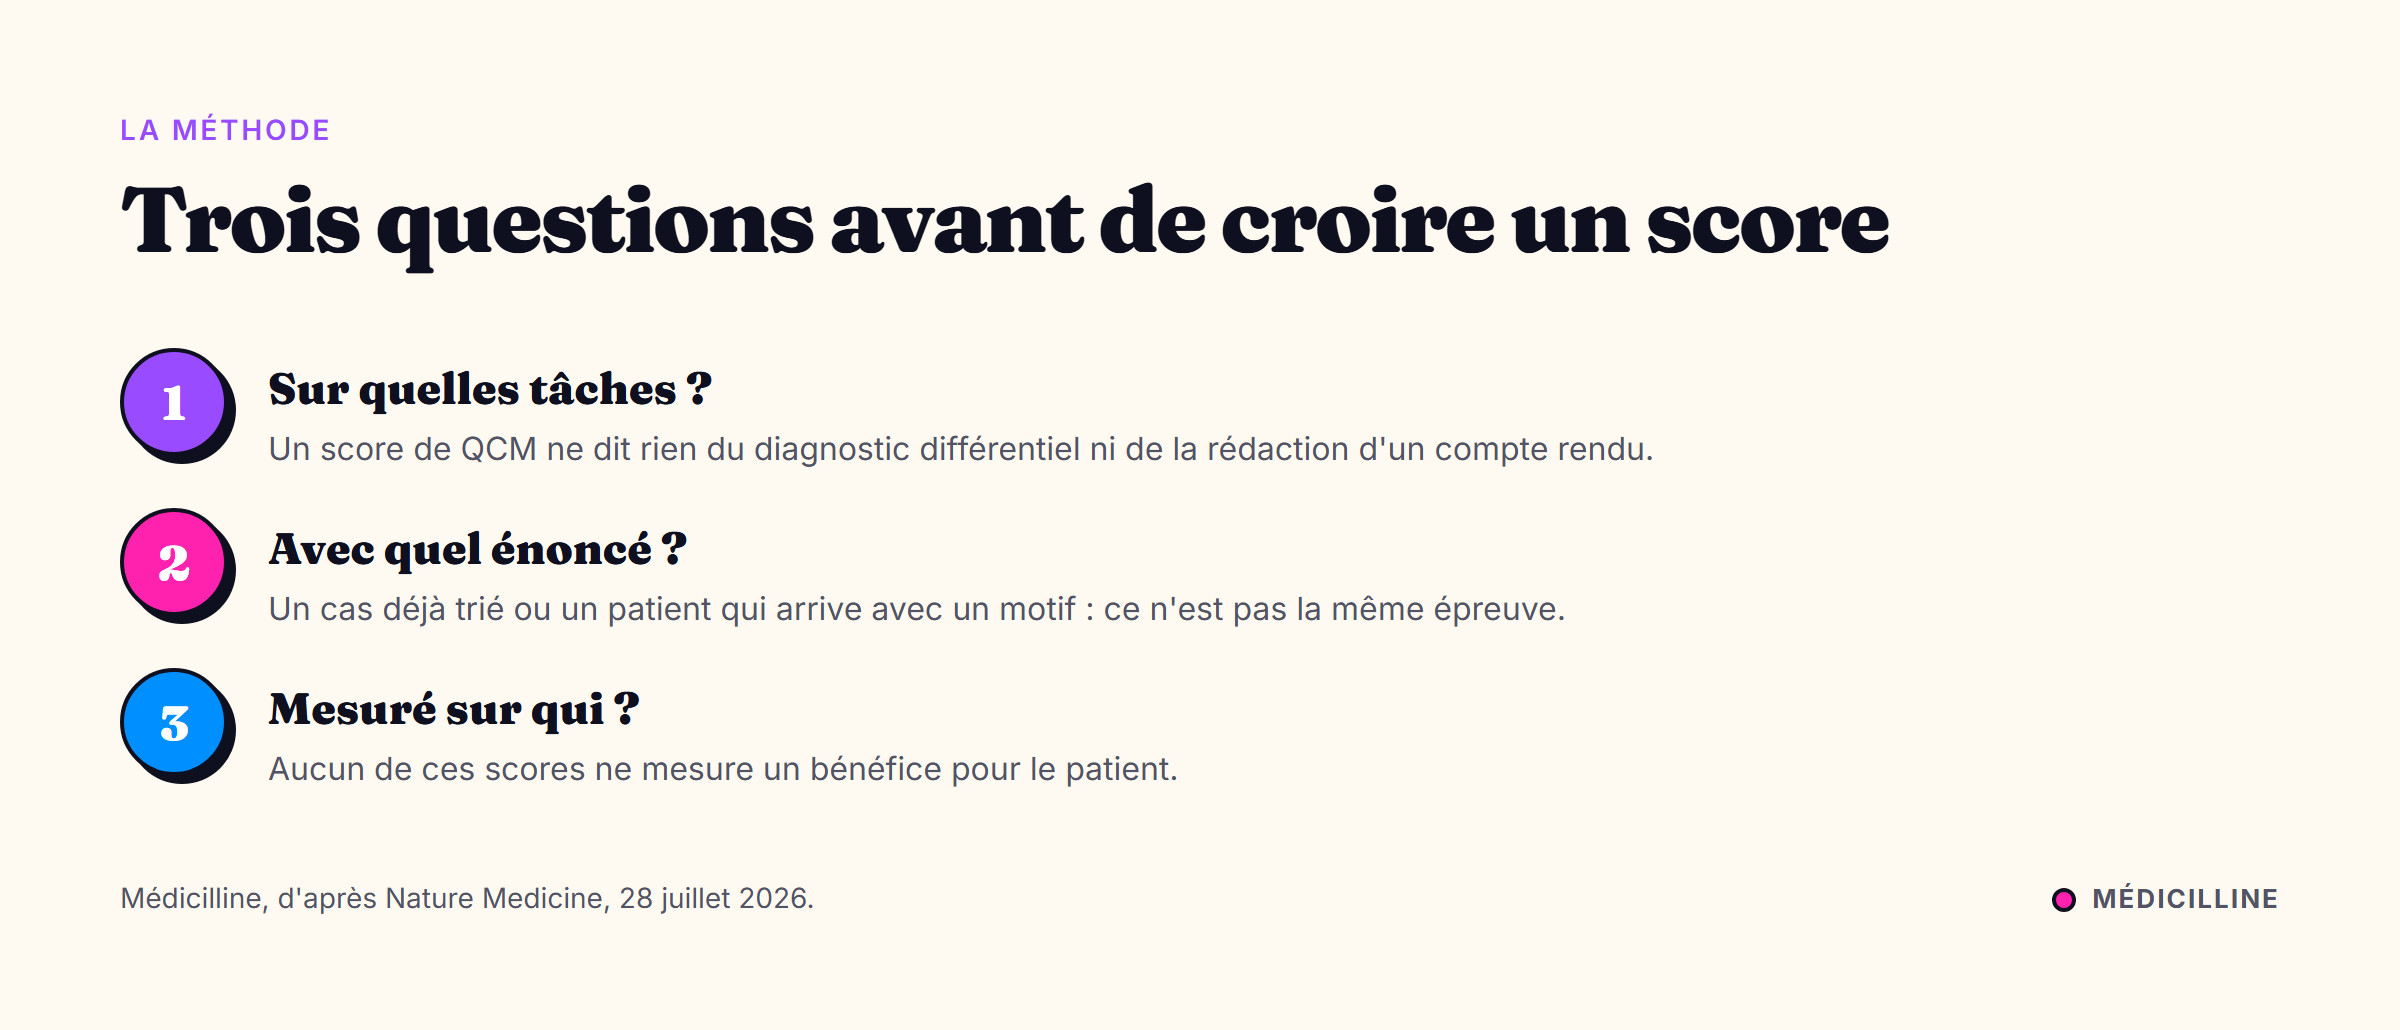
Ces réserves valent pour l'étude elle-même. Ce sont des scores de benchmark agrégés sur des modèles généralistes, sans mesure de morbi-mortalité, et le cadre proposé n'a été repris par aucun régulateur à ce jour. Il décrit un écart ; il ne mesure pas un bénéfice ou un risque pour un patient.
Sources
- « Toward a test of medical AI superintelligence », Nature Medicine — 28 juillet 2026
- Clinical Trial Vanguard — analyse du cadre d'évaluation de Nature Medicine et de ce que la guidance FDA n'aborde pas encore — 28 juillet 2026
Les visuels de données et de méthode sont produits par Médicilline à partir des sources ci-dessus ; chacun porte sa source et sa limite d'interprétation. Les photographies proviennent de Pexels, créditées sous l'image.